게시글 상세 페이지의 메타 설명을 본문에서 자동으로 만들도록 바꿨습니다. 처음에는 잘 되는 것처럼 보였습니다. 그런데 어느 날 검색 결과 요약문에 사람이 읽을 문장이 아니라 JSON 코드가 그대로 들어간 것을 발견했습니다.
문제는 본문 정제 함수였습니다. 태그를 지우고 길이를 자른 뒤에 구조화 데이터를 제거하려고 했는데, 이미 JSON이 중간에서 잘린 상태라 제거 패턴이 맞지 않았습니다.
이 글은 메타 설명을 자동 생성하는 방법만 설명하는 글이 아닙니다. 본문에 섞여 들어간 구조화 데이터와 스크립트 코드를 걸러내면서, 왜 정제 순서가 중요한지 실제 PHP 코드 기준으로 정리한 글입니다.
요약문에 JSON이 노출된 상황
문제가 된 메타 설명은 이런 형태였습니다.
{"@context":"https://schema.org","@type":"BreadcrumbList","itemListEle...원래라면 게시글 본문 앞부분이 들어가야 했습니다. 하지만 사람에게 보여줄 설명 자리에 구조화 데이터 코드가 들어갔습니다.
증상은 일정하지 않았습니다.
- 일부 게시글은 정상 설명 출력
- 일부 게시글은 JSON 문자열로 시작
- 일부 메타 설명은 따옴표 때문에 태그가 깨짐
- 검색 결과와 SNS 미리보기 설명에도 같은 문제가 이어짐
깨진 글들을 모아보니 공통점이 있었습니다. 예전에 다른 페이지에서 복사해 붙여넣은 글들이었습니다. 복사 과정에서 브레드크럼 구조화 데이터나 스크립트 조각이 본문 텍스트처럼 같이 저장되어 있었습니다.
처음 작성했던 잘못된 정제 순서
처음 코드는 단순했습니다.
<?php
$desc = strip_tags($content);
$desc = mb_substr($desc, 0, 150, 'UTF-8');
$desc = removeSchemaJson($desc);
$desc = htmlspecialchars($desc, ENT_QUOTES, 'UTF-8');
?>
겉으로 보면 문제가 없어 보입니다. 태그를 지우고, 150자로 자르고, 스키마 JSON을 제거하고, 출력 직전에 이스케이프합니다.
하지만 순서가 잘못됐습니다. JSON 구조화 데이터는 보통 긴 문자열입니다. 150자로 먼저 잘라버리면 닫는 괄호나 배열 구조가 사라집니다.
{"@context":"https://schema.org","@type":"BreadcrumbList","itemListEle...이렇게 잘린 문자열에는 원래 정규식이 찾으려던 완전한 JSON 덩어리가 남아 있지 않습니다. 그래서 제거 함수가 아무것도 지우지 못했습니다.
자르기 전에 큰 덩어리부터 제거
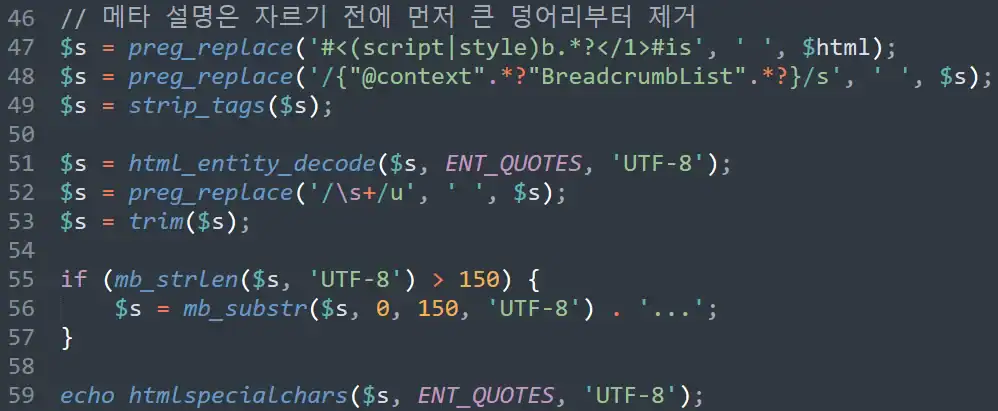
해결 기준은 간단했습니다. 길이를 자르기 전에 먼저 제거할 것을 모두 제거해야 합니다.
<?php
function buildMetaDescription(string $html, int $limit = 150): string
{
    $s = $html;

    // 1. script, style 블록은 내용까지 통째로 제거
    $s = preg_replace('#<(script|style)\b.*?</\1>#is', ' ', $s);

    // 2. 본문에 텍스트로 섞인 BreadcrumbList JSON 제거
    $s = preg_replace(
        '/\{"@context".*?"@type"\s*:\s*"BreadcrumbList".*?\}\s*\]\s*\}/s',
        ' ',
        $s
    );

    // 3. 남은 ListItem 조각 제거
    $s = preg_replace('/[,\s]*\{"@type"\s*:\s*"ListItem".*?\}/s', ' ', $s);

    // 4. 앞쪽에 남은 괄호, 쉼표 찌꺼기 제거
    $s = preg_replace('/^[\s\]\}\[\{,]+/u', '', $s);

    // 5. HTML 태그 제거
    $s = strip_tags($s);

    // 6. 엔티티 복원과 공백 정리
    $s = html_entity_decode($s, ENT_QUOTES, 'UTF-8');
    $s = preg_replace('/\s+/u', ' ', $s);
    $s = trim($s);

    // 7. 마지막에 길이 자르기
    if (mb_strlen($s, 'UTF-8') > $limit) {
        $s = mb_substr($s, 0, $limit, 'UTF-8') . '...';
    }

    // 8. 출력 직전 이스케이프
    return htmlspecialchars($s, ENT_QUOTES, 'UTF-8');
}
?>
순서를 정리하면 아래와 같습니다.
큰 덩어리 제거 → 태그 제거 → 엔티티 복원 → 공백 정리 → 길이 자르기 → 이스케이프핵심은 자르기가 뒤쪽에 있어야 한다는 점입니다. 문자열을 먼저 잘라버리면 뒤에서 제거할 패턴이 깨집니다.
strip_tags보다 script 제거가 먼저
처음에는 strip_tags()를 먼저 쓰면 script 태그도 사라질 거라고 생각했습니다. 하지만 strip_tags()는 태그만 제거하고 태그 안의 내용은 남깁니다.
<?php
echo strip_tags('<script>var a = 1;</script>본문');
?>
결과는 이렇게 됩니다.
var a = 1;본문메타 설명에는 태그가 아니라 텍스트가 들어갑니다. 그러니 스크립트 안의 코드가 그대로 설명에 섞일 수 있습니다.
그래서 script와 style은 태그 제거보다 먼저 통째로 지워야 했습니다.
<?php
$s = preg_replace('#<(script|style)\b.*?</\1>#is', ' ', $html);
$s = strip_tags($s);
?>
이 순서가 바뀌면 코드 조각이 설명문에 남을 수 있습니다.
이스케이프는 가장 마지막
반대로 htmlspecialchars()는 마지막에 해야 합니다. 중간에 이스케이프를 먼저 하면 "가 "로 바뀌고, 길이 계산에도 그 문자열이 그대로 들어갑니다.
<?php
$s = htmlspecialchars($s, ENT_QUOTES, 'UTF-8');
$s = mb_substr($s, 0, 150, 'UTF-8');
?>
이런 순서로 처리하면 엔티티가 중간에서 잘릴 수 있습니다.
&quo
"또 이스케이프된 문자열 기준으로 길이를 자르면 실제 사용자에게 보이는 글자 수와 달라집니다.
안전한 순서는 아래처럼 잡았습니다.
정제 → 글자 수 자르기 → 출력 직전 이스케이프메타 태그의 content 속성 안에 따옴표가 들어갈 수 있으므로 이스케이프 자체는 반드시 필요합니다. 다만 시점이 마지막이어야 했습니다.
글자 수는 바이트가 아니라 문자 기준
한국어 설명문은 바이트 기준으로 자르면 글자가 깨질 수 있습니다. 그래서 substr()가 아니라 mb_substr()를 사용했습니다.
<?php
if (mb_strlen($s, 'UTF-8') > $limit) {
    $s = mb_substr($s, 0, $limit, 'UTF-8') . '...';
}
?>strlen()은 바이트 길이를 봅니다. 한글은 UTF-8에서 여러 바이트로 표현되기 때문에 의도보다 짧게 잘리거나, 잘못 처리하면 깨진 문자열이 생길 수 있습니다.
메타 설명처럼 사용자에게 바로 노출되는 문장은 문자 기준으로 자르는 편이 안전했습니다.
빈 설명일 때 기본값 처리
본문 정제를 거쳤는데 아무 내용도 남지 않는 경우도 있었습니다. 이미지나 코드만 있는 글, 본문이 짧은 글, 복사된 스크립트만 남아 있던 글에서 이런 일이 생겼습니다.
이때는 빈 description을 그대로 출력하지 않고 제목 기반 기본값을 넣었습니다.
<?php
function fallbackDescription(string $title, string $siteName): string
{
    $text = $title . '에 대한 ' . $siteName . ' 게시글입니다.';
    return htmlspecialchars($text, ENT_QUOTES, 'UTF-8');
}

$description = buildMetaDescription($postBody, 150);

if ($description === '') {
    $description = fallbackDescription($postTitle, $siteName);
}
?>
자동 생성 함수는 항상 예외를 생각해야 했습니다. 본문에서 설명을 뽑을 수 없는 글도 있기 때문입니다.
OG 설명과 Twitter 설명에도 재사용
같은 문제가 메타 description에만 생기는 것이 아니었습니다. 카카오톡 공유 설명, 페이스북 오픈그래프 설명, Twitter 카드 설명도 본문 요약을 같이 쓰고 있었습니다.
그래서 같은 함수를 길이만 다르게 재사용했습니다.
<?php
$metaDesc = buildMetaDescription($postBody, 150);
$ogDesc   = buildMetaDescription($postBody, 100);
$twDesc   = buildMetaDescription($postBody, 100);

echo '<meta name="description" content="' . $metaDesc . '">' . "\n";
echo '<meta property="og:description" content="' . $ogDesc . '">' . "\n";
echo '<meta name="twitter:description" content="' . $twDesc . '">' . "\n";
?>
설명 생성 규칙을 여러 군데에 따로 만들면 나중에 하나만 고쳐지고 다른 곳은 그대로 남을 수 있습니다. 그래서 본문 정제는 하나의 함수로 모으는 편이 안전했습니다.
저장 시점에서도 한 번 더 정리
메타 설명 함수만 고치는 것은 증상 치료에 가까웠습니다. 근본 원인은 본문 DB에 구조화 데이터 코드가 텍스트로 저장되어 있다는 점이었습니다.
그래서 새 글을 저장할 때도 같은 계열의 정제 로직을 추가했습니다.
<?php
function cleanPostBodyBeforeSave(string $html): string
{
    $html = preg_replace('#<(script|style)\b.*?</\1>#is', ' ', $html);
    $html = preg_replace('/\{"@context".*?"BreadcrumbList".*?\}/s', ' ', $html);

    return trim($html);
}
?>
이미 저장된 글은 별도 스크립트로 정리했습니다. 다만 DB를 직접 수정하는 작업이라 먼저 백업을 받았습니다.
mysqldump -u user -p database posts > posts_backup.sql그리고 정리 스크립트는 실행 후 바로 삭제했습니다. 임시 스크립트가 서버에 남아 있으면 또 다른 위험이 될 수 있기 때문입니다.
수정 후 확인한 출력
수정 후에는 페이지 소스에서 description이 정상인지 확인했습니다.
curl -s https://example.com/board/856 | grep -i 'name="description"'
curl -s https://example.com/board/856 | grep -i 'og:description'
브라우저 개발자 도구에서도 <head> 안의 태그가 깨지지 않았는지 확인했습니다.
정상 결과는 이런 형태였습니다.
<meta name="description" content="게시글 본문 앞부분이 자연스럽게 들어갑니다...">
<meta property="og:description" content="게시글 본문 앞부분이 들어갑니다...">
따옴표가 중간에 끊기거나, JSON 조각이 앞에 남거나, &quo 같은 잘린 엔티티가 있으면 다시 정제 순서를 확인해야 합니다.
적용 후 달라진 점
정제 순서를 바꾼 뒤 설명문 품질이 안정됐습니다.
- 메타 설명에 JSON 코드가 노출되는 문제 해결
- script, style 코드 조각 제거
- 따옴표 때문에 meta 태그가 깨지는 문제 감소
- 본문 요약을 150자로 자른 뒤 말줄임표 추가
- OG, Twitter 설명에도 같은 정제 함수 재사용
- 본문 저장 시점에서도 불필요한 코드 유입 차단
가장 큰 변화는 일부 글만 깨지던 불규칙한 문제가 줄었다는 점입니다. 정제 순서를 고정하니 예외가 훨씬 줄었습니다.
본문 정제 체크리스트
문자열 가공은 순서가 결과를 결정
이번 문제는 정규식 하나가 틀려서 생긴 문제가 아니었습니다. 더 큰 원인은 순서였습니다. 먼저 잘라버린 뒤 제거하려고 하니, 제거할 대상의 형태가 이미 깨져 있었습니다.
제가 얻은 기준은 단순합니다. 먼저 큰 덩어리를 지우고, 태그를 걷어내고, 공백을 정리하고, 마지막에 길이를 자릅니다. 그리고 메타 태그에 넣기 직전에 이스케이프합니다.
자동 요약문은 한 번 만들어두면 여러 곳에서 쓰입니다. 그래서 정제 순서가 틀리면 검색 결과, 카카오톡 공유, SNS 카드까지 같은 문제가 반복됩니다. 본문에서 설명을 뽑는 함수는 작아 보여도 SEO와 공유 화면에 직접 영향을 주는 코드였습니다.