게시판 검색 URL을 짧게 바꾸고 나니 새로운 고민이 생겼습니다. 예전에는 복잡한 쿼리스트링이라 검색엔진에 보여주고 싶지 않았지만, 이제는 사람이 공유해도 어색하지 않은 주소가 됐습니다.
/mysite/board/856/search?keyword=테트리스주소가 깔끔해지면 질문이 바뀝니다. 이 검색 결과 페이지를 색인시켜도 될까, 아니면 전부 noindex로 막아야 할까. 처음에는 둘 중 하나를 고르는 문제라고 생각했습니다.
하지만 실제로는 검색 결과 페이지도 상태가 다릅니다. 결과가 충분히 있는 검색 페이지와 결과가 하나도 없는 검색 페이지를 같은 기준으로 다루면 문제가 생겼습니다.
검색 결과 페이지를 모두 막기 어려운 이유
검색 결과 페이지는 위험한 면이 있습니다. 키워드 조합만큼 페이지가 거의 무한하게 생길 수 있고, 결과가 없는 페이지도 많이 만들어집니다.
/search?keyword=a
/search?keyword=aa
/search?keyword=test
/search?keyword=없는단어
이런 페이지를 전부 색인시키면 얇은 페이지가 늘어납니다. 검색어 없는 페이지나 결과 0건 페이지가 검색 결과에 노출되면 사용자 경험도 좋지 않습니다.
그렇다고 검색 결과를 전부 noindex로 막기도 아쉬웠습니다. 오래된 게시판에서는 검색 결과 페이지가 내부 글을 찾는 진입로 역할을 할 수 있었기 때문입니다.
- 사용자가 실제로 찾는 키워드 조합이 있음
- 목록 첫 페이지에서는 보이지 않는 오래된 글로 연결됨
- 특정 주제 글을 묶어 보여주는 페이지가 됨
- 내부 링크를 따라 크롤러가 더 깊은 글을 발견할 수 있음
그래서 검색 결과 페이지를 하나의 규칙으로 처리하지 않고, 결과 수와 검색어 유무에 따라 나누기로 했습니다.
결과 수로 색인 여부 나누기
가장 먼저 정한 기준은 검색어와 결과 수였습니다.
<?php
$isSearch  = ($pageType === 'search');
$keyword   = trim($keyword ?? '');
$hasQuery  = ($keyword !== '');
$resultCnt = (int)$totalCount;

if ($isSearch && (!$hasQuery || $resultCnt === 0)) {
    echo '<meta name="robots" content="noindex,follow">' . "\n";
}
?>
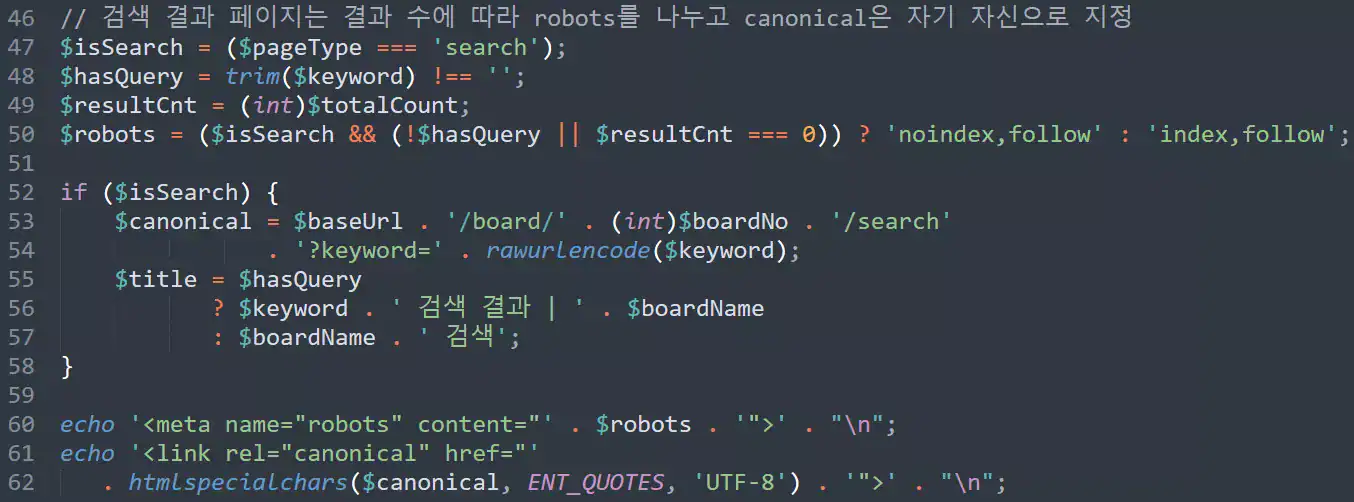
검색어가 없거나 결과가 0건이면 색인에서 제외했습니다. 반대로 실제 결과가 있는 검색 페이지는 기본 색인 가능 상태로 뒀습니다.
여기서 noindex,follow를 쓴 것이 중요했습니다.
noindex → 이 검색 결과 페이지 자체는 검색 결과에 넣지 않음
follow  → 페이지 안의 링크는 계속 따라감
검색 결과 페이지 자체는 얇을 수 있지만, 그 안에 있는 게시글 링크는 크롤러가 따라가도 됩니다. noindex,nofollow로 막으면 검색을 통해서만 발견되는 글의 경로까지 줄어들 수 있습니다.
canonical을 목록으로 보내지 않은 이유
가장 헷갈렸던 부분은 canonical이었습니다. 검색 결과 페이지가 많아지는 것이 걱정돼서, 검색 페이지의 canonical을 게시판 목록으로 보내면 어떨까 생각했습니다.
<link rel="canonical" href="https://example.com/mysite/board/856">하지만 이건 맞지 않았습니다. canonical은 내용이 사실상 같은 페이지의 대표 주소를 알려주는 태그입니다. 검색 결과 페이지와 전체 목록 페이지는 같은 내용이 아닙니다.
예를 들어 아래 두 페이지는 목적이 다릅니다.
/mysite/board/856
/mysite/board/856/search?keyword=테트리스
첫 번째는 전체 목록이고, 두 번째는 테트리스 검색 결과입니다. 둘을 같은 페이지라고 말하면 검색엔진이 canonical을 무시하거나, 엉뚱한 주소를 대표로 판단할 수 있습니다.
그래서 검색 결과 페이지도 자기 자신을 canonical로 지정했습니다.
페이지 유형별 canonical 분기
최종 canonical 분기는 목록, 상세, 검색을 나눠 처리했습니다.
<?php
$base = 'https://example.com/' . rawurlencode($siteId);

if ($isSearch) {
    $canonical = $base . '/board/' . (int)$boardNo . '/search'
               . '?keyword=' . rawurlencode($keyword);
} elseif ($postNo) {
    $canonical = $base . '/board/' . (int)$boardNo . '/' . (int)$postNo;
} else {
    $canonical = $base . '/board/' . (int)$boardNo
               . ($start > 0 ? '?start=' . (int)$start : '');
}

echo '<link rel="canonical" href="'
   . htmlspecialchars($canonical, ENT_QUOTES, 'UTF-8')
   . '">' . "\n";
?>
핵심은 단순했습니다.
목록 페이지 → 자기 자신
목록 2페이지 이후 → 자기 자신
글 상세 → 자기 자신
검색 결과 → 자기 자신
결과 0건 검색 → 자기 자신 + noindex,follow
canonical은 대표 주소를 알려주는 역할이고, robots는 색인 여부를 제어하는 역할입니다. 둘을 섞지 않는 것이 중요했습니다.
robots와 canonical 역할 분리
처음에는 canonical로 색인을 제어하려고 했습니다. 검색 결과를 목록으로 canonical 처리하면 검색 결과가 정리될 것 같았습니다.
하지만 실제로는 역할이 다릅니다.
| 태그 | 역할 | 잘못 쓰면 생기는 문제 |
|---|---|---|
canonical | 중복 페이지의 대표 주소 지정 | 다른 내용의 페이지를 같은 것으로 오해시킴 |
robots | 색인 여부와 링크 추적 제어 | 필요한 페이지까지 색인에서 제외 |
검색 결과 페이지가 색인에 부적합한 경우에는 canonical이 아니라 robots로 처리해야 했습니다.
<meta name="robots" content="noindex,follow">반대로 검색 결과가 실제 콘텐츠 묶음으로 의미가 있다면 자기 자신을 canonical로 두고 색인 가능 상태로 둡니다.
title에 검색어 반영
검색 결과 페이지를 색인 가능하게 둘 수 있다면 title도 고유해야 합니다. 예전에는 검색 페이지 title이 전부 사이트명이나 게시판명으로만 출력되고 있었습니다.
게임 게시판 | 사이트명
게임 게시판 | 사이트명
게임 게시판 | 사이트명
검색어가 다른데 title이 같으면 중복 제목으로 보일 수 있습니다. 그래서 검색어를 title에 넣었습니다.
<?php
if ($isSearch && $hasQuery) {
    $title = $keyword . ' 검색 결과 | ' . $boardName . ' | ' . $siteName;
} elseif ($postNo) {
    $title = $postTitle . ' | ' . $boardName . ' | ' . $siteName;
} else {
    $title = $boardName
           . ($start > 0 ? ' ' . $pageNum . '페이지' : '')
           . ' | ' . $siteName;
}

echo '<title>'
   . htmlspecialchars($title, ENT_QUOTES, 'UTF-8')
   . '</title>';
?>
사용자 입력이 title에 들어가기 때문에 htmlspecialchars()는 필수였습니다. 검색어에 따옴표나 부등호를 넣은 요청이 실제 로그에 남아 있었기 때문입니다.
H1도 페이지 목적에 맞추기
title만 바꾸고 H1을 그대로 두면 화면과 검색 결과의 맥락이 어긋날 수 있습니다. 검색 결과 페이지에서는 H1도 검색어 기준으로 바꿨습니다.
<?php
if ($isSearch && $hasQuery) {
    $h1 = $keyword . ' 검색 결과';
} elseif ($postNo) {
    $h1 = $postTitle;
} else {
    $h1 = $boardName;
}

echo '<h1>' . htmlspecialchars($h1, ENT_QUOTES, 'UTF-8') . '</h1>';
?>
이렇게 하면 페이지 유형별로 구조가 분명해집니다.
| 페이지 유형 | title | H1 |
|---|---|---|
| 게시판 목록 | 게시판명 | 사이트명 | 게시판명 |
| 목록 2페이지 | 게시판명 2페이지 | 사이트명 | 게시판명 |
| 글 상세 | 글 제목 | 게시판명 | 사이트명 | 글 제목 |
| 검색 결과 | 검색어 검색 결과 | 게시판명 | 사이트명 | 검색어 검색 결과 |
목록, 상세, 검색 결과가 같은 템플릿을 쓰더라도 title과 H1은 같은 값으로 두지 않았습니다.
결과 0건 페이지 처리
검색어가 있어도 결과가 0건이면 색인할 이유가 거의 없습니다. 이 페이지는 사용자에게도 검색엔진에게도 얇은 페이지입니다.
<?php
if ($isSearch && $hasQuery && $resultCnt === 0) {
    echo '<meta name="robots" content="noindex,follow">' . "\n";
}
?>
다만 화면에서는 친절하게 안내 문구를 보여줬습니다.
<?php if ($isSearch && $resultCnt === 0): ?>
    <p>검색 결과가 없습니다. 다른 키워드로 다시 검색해 보세요.</p>
<?php endif; ?>
색인에서는 제외하되, 사용자가 들어왔을 때는 다음 행동을 할 수 있게 만든 것입니다.
검색어 없는 검색 페이지 처리
검색어가 없는 검색 페이지도 색인 대상에서 제외했습니다.
/mysite/board/856/search
/mysite/board/856/search?keyword=
이런 페이지는 실제 검색 결과라기보다 빈 검색 화면에 가깝습니다. 그래서 noindex,follow를 넣었습니다.
가능하다면 검색어 없는 요청은 목록 페이지로 돌리는 것도 방법입니다.
<?php
if ($isSearch && !$hasQuery) {
    header('Location: ' . $base . '/board/' . (int)$boardNo, true, 302);
    exit;
}
?>
다만 301로 고정하기보다는 상황에 따라 302 또는 noindex 처리가 더 안전했습니다. 검색어 없는 검색 화면은 사용자가 다시 검색할 수 있는 UI일 수도 있기 때문입니다.
배포 후 확인한 항목
수정 후에는 페이지 유형별로 소스를 확인했습니다.
curl -s "https://example.com/mysite/board/856" | grep -Ei 'canonical|robots|<title>'
curl -s "https://example.com/mysite/board/856?start=20" | grep -Ei 'canonical|robots|<title>'
curl -s "https://example.com/mysite/board/856/search?keyword=테트리스" | grep -Ei 'canonical|robots|<title>'
curl -s "https://example.com/mysite/board/856/search?keyword=없는단어" | grep -Ei 'canonical|robots|<title>'
브라우저에서는 H1도 확인했습니다.
document.querySelector('h1')?.textContent.trim()확인 기준은 아래와 같았습니다.
결과 있는 검색 → self canonical, index 가능, 검색어 title/H1
결과 0건 검색 → self canonical, noindex,follow
검색어 없는 검색 → noindex,follow 또는 목록으로 이동
목록 2페이지 → 1페이지 canonical 금지, 2페이지 자기 자신
적용 후 달라진 점
적용 후에는 검색 결과 페이지를 무조건 막거나 무조건 열어두는 상태에서 벗어났습니다.
- 결과 0건 검색 페이지가 색인 대상에서 제외됨
- 검색어 없는 검색 페이지가 얇은 페이지로 색인되지 않음
- 결과 있는 검색 페이지는 자기 canonical 유지
- 검색 페이지마다 title과 H1이 고유하게 출력
- 목록 2페이지 이후도 1페이지와 구분
- canonical과 robots 역할이 분리됨
- 검색을 통해서만 닿는 오래된 글은 follow로 발견 가능
특히 canonical을 목록으로 몰아넣지 않은 것이 중요했습니다. 검색 결과와 목록은 같은 페이지가 아니므로, 억지 canonical보다 robots 분기가 더 안전했습니다.
검색 결과 색인 체크리스트
색인 여부보다 조건 분리 먼저
검색 결과 페이지는 색인할지 말지를 하나로 결정할 대상이 아니었습니다. 같은 검색 템플릿이라도 결과가 있는 페이지와 결과가 없는 페이지는 가치가 다릅니다.
제가 얻은 기준은 단순합니다. 결과가 있는 검색은 실제 콘텐츠 묶음으로 볼 수 있고, 결과가 없는 검색은 색인에서 제외합니다. 검색어가 없는 검색 페이지도 얇은 페이지가 되기 쉬우므로 noindex 또는 목록 이동으로 처리합니다.
canonical은 중복 대표 주소를 알려주는 태그이고, robots는 색인 여부를 제어하는 태그입니다. 검색 결과 페이지를 목록으로 canonical 처리하는 방식은 이 둘의 역할을 섞는 실수였습니다.
검색 결과 페이지를 설계할 때는 “색인할까 말까”보다 먼저 “이 페이지가 지금 어떤 상태인가”를 나눠야 했습니다. 그다음 title, H1, canonical, robots를 같은 기준으로 맞추는 것이 안정적이었습니다.